terça-feira, 13 de janeiro de 2015

Porque quereria uma TV ou um Monitor de PC curvos?

As TVs curvas estavam em todo o lado, na CES 2015.

Não estamos a exagerar: quase todas as TVs que estavam a ser mostradas eram curvas, em vez de ecran plano! E não eram somente TVs. A Samsung também estava a apresentar monitores de computador curvos.

Mas qual é, afinal, a vantagem de uma TV curva? As TVs 4K serão úteis, um dia, mas não temos tanta certeza sobre as TVs curvas.

Ecrans curvos, o quê?

imageLembra-se quando o "ecran plano" era a última novidade? Aqueles velhos monitores CRT curvados para fora e os ecrans planos pareciam ser o futuro.

Bem, os ecrans curvos estão na berra outra vez - pelo menos é isso que os fabricantes de televisores e monitores de computadores nos querem fazer pensar. Lembre-se, porém, que estes são os mesmos fabricantes que andavam a empurrar a TV 3D apenas há alguns anos atrás e agora desistiram daqueles TVs 3D.

TVs e monitores de computador curvos são exatamente aquilo que parecem. O ecran não é plano, mas curvo – ao redor do seu rosto, em teoria - para fornecer um campo de visão mais amplo. Os fabricantes de TV parecem pensar que esta é uma experiência mais imersiva.

As maiores desvantagens

Os fabricantes simplesmente não têm conseguido arranjar argumentos muito convincentes para os ecrans curvos. Eles estão um pouco naquela onda da tecnologia para o bem da tecnologia. E frases como "objetos curvos são um alívio e despertam prazer nos nossos cérebros", do stand da Samsung, não contam como um bom argumento!

A Samsung, LG, Sony e vários outros fabricantes descobriram como produzir ecrans curvos e estão a mostrar que conseguem. Os ecrans curvos são uma coisa nova, que eles não conseguiam fabricar há apenas alguns anos atrás.

Existem vários grandes problemas com os ecrans curvos. O maior problema é o ângulo de visão preciso que eles exigem. Para obter a imagem ideal, é necessário estar diretamente em frente à TV curva. Se estiver apenas um pouco de lado, a imagem no ecran curvo não vai parecer correcta. Pode sempre argumentar que deverá corrigir a posição, mas o que fazer se tiver outros membros da família ou amigos a ver TV consigo? As TVs curvas não são muito boas para conjuntos de várias pessoas (e boa sorte para a montagem de uma TV curva numa parede).

Para corrigir este problema, a Samsung e a LG demonstraram TVs "flexíveis" no ano passado, na CES 2014. Ao carregar num botão do controlo remoto da TV, o ecran plano transformava-se num ecran curvo e vice-versa. A Samsung e a LG não estavam a exibir os modelos flexíveis este ano. E seria uma coisa muito insensata de se comprar, mesmo que estivesse à venda. Afinal, uma TV flexível seria muito mais caro do que até mesmo uma TV curva.

As TVs curvas são mais caras de fabricar, pelo que também são mais caras quando as comprar. Tem que pagar bastante mais por um ecran curvo do que por um ecran plano. E, francamente, não parecem necessariamente melhores quando estamos em pé à frente deles. Os ecrans curvos são impressionantes do ponto de vista da tecnologia, mas parecem um pouco estranhos – um bom ecran plano seria o suficiente.


As vantagens teóricas

Os ecrans curvos, teoricamente, oferecem um maior campo de visão e uma experiência mais imersiva. Para disfrutar realmente destes benefícios, precisará de uma enorme TV de 100” e de estar sentado próximo dela. Isso pode-lhe proporcionar uma experiência mais "cinematográfica". Mas provavelmente não quer uma TV tão grande e também não vai querer sentar-se tão perto. E se tiver uma TV mais pequena, como a maioria das pessoas, um ecran curvo realmente não faz sentido.

Na CES 2015, a TCL mostrou uma TV 4K curva, de 110”. Em tais tamanhos, um ecran curvo poderia fazer mais sentido para que possa ver cada pedacinho daquela área massiva, de uma só vez. Mas, tão depressa, não vai ser proprietário de um produto como este, já que a TCL nem sequer tem quaisquer planos para vendê-lo. Eles só queriam ombrear com a Samsung.

A Samsung está a vender uma TV 4K curva de 55”, na Amazon, por pouco menos de 2000 dólares. O ecran curvo só vai ser realmente útil, se estiver sentado à frente da TV e muito mais perto dela do que é normal. É apenas um chamariz para aquele tamanho.

Um ecran curvo também pode reduzir, teoricamente, os reflexos na própria TV, mas isso não nos pareceu muito visível. Se quiser reduzir os reflexos, existem coisas melhores que pode fazer e que não terão um impacto negativo sobre os ângulos de visão.

E monitores de computador curvos?

Todas as considerações anteriores são basicamente as mesmas para monitores de computador. A menos que saiba realmente por que quer um monitor curvo para o seu computador, não compre nenhum. Provavelmente poderá obter vários bons ecrans planos, pelo mesmo preço, e colocá-los lado a lado numa configuração dual-monitor ou triple-monitor. Vários monitores seria mais útil e mais funcional, também.

Poderá querer um monitor 4K, mas, provavelmente, não quer um monitor curvo!

Considerações finais

Em última análise, ecrans curvos permitirão a existência de novos tipos de tecnologia. Uma pulseira com um display curvo, em torno de seu pulso faz sentido - o Samsung Galaxy Fit funciona exactamente desta forma. Um ecran de smartphone curvo poderia fazer algum sentido, também. Mas a TV de 50”, na sua sala de estar, não precisa ser curva - é apenas um chamariz que lhe vai custar mais caro.

Nós não recomendamos a compra de uma TV curva. Os fabricantes, na verdade, ainda não explicaram por que devemos querer uma. É muito impressionante que eles possam construir ecrans curvos - apenas se eles tiverem um motivo real para o fazer!

Tradução livre do artigo "Why Would You Want a Curved TV or Computer Monitor?", de Chris Hoffman para a How-To-Geek.

segunda-feira, 12 de janeiro de 2015

TVs e Monitores UHD (4K, 5K,… 8K) - Vale a pena comprar?

Introdução

Nos últimos meses temos assistido a uma proliferação da oferta de monitores e Tvs Ultra HD, mais vulgarmente conhecidas por 4K (já existem resoluções 5K e 8K também). Na última campanha do Natal, foi comum ver vários modelos de diversas marcas em exposição nas grandes superfícies comerciais.

Neste segmento, existem considerações diferentes a levar em conta, quando se trata de adquirir uma TV ou simplesmente um monitor de computador. Mas em qualquer dos casos, apesar de alguma pressão comercial e duma nítida baixa de preços, a grande questão continua a ser: vale apena comprar uma TV ou um monitor 4K?

Neste artigo, vamos dar uma ajuda a responder a esta e mais algumas questões sobre este mundo do Ultra HD.

Conteúdo

Considerações sobre Resolução de Ecrans

Quando se fala em HD, Full HD, Ultra HD, estamos a falar de normas de resolução de ecrans. Mas afinal o que é isso da resolução? E o que devemos levar em conta, relacionado com a resolução?

Para responder a estas questões, temos primeiro que perceber como é formada uma imagem no ecran duma TV ou dum monitor de PC.

A imagem é dividida em linhas verticais e horizontais, que formam uma grelha de pequenos rectângulos, chamados pixéis. Cada pixel tem uma dada cor e tonalidade, que variam, conforme a posição onde se encontram na imagem. Quantas mais linhas verticais e/ou horizontais tiver uma imagem, maior é o número de pixéis que definem essa imagem.

A resolução não é mais do que o número de pixéis distintos que podem ser mostrados em cada dimensão. Normalmente é apresentada como largura x altura (width x height), com as unidades em pixéis. P.ex. 640 x 480 significa 640 pixéis na largura e 480 pixéis na altura (para um total de 640x480=307.200 pixéis).

Mas chega esta resolução, digamos linear, para auferir a qualidade duma imagem ou de um monitor? Não! Devemos levar em linha de conta outros factores.

Para além da quantidade total de pixéis, devemos também levar em linha de conta a área por que esses pixéis se vão distribuir. Estamos então a falar em densidade de pixéis, que costuma ser medida em Pontos Por Polegada (DPI). Quanto maior for o nosso monitor, mais pixéis deverá ter, para manter a mesma densidade. Doutra forma, o tamanho dos pixéis terá que ser maior, para conseguir preencher uma área maior, o que piora a qualidade da imagem.


Neste caso, também devemos levar em linha de conta a distância a que nos encontramos a olhar para o ecran. Quando mais próximos, maior a quantidade de pixéis, para manter a qualidade da imagem. De realçar que é costume estarmos mais próximos do monitor do computadores do que da TV, por isso é normal termos TVs de muito maiores dimensões (36”, 40”,…) que os monitores de computador (15”, 17”) e termos uma percepção de qualidade semelhante para a mesma resolução. Se estivéssemos à mesma distância da TV, que estamos do monitor, a imagem iria parecer-nos de muito pior qualidade.

No caso dos ecrans de TV e monitores de computador, como nos são apresentadas imagens em movimento, também é muito importante a velocidade de actualização de ecran (refresh rate), isto é, quantas vezes por segundo a imagem é actualizada no ecran. Infelizmente, muitas vezes temos ecrans de alta definição, mas com baixas taxas de varrimento (p.ex. 30Hz) o que leva a experiências fracas em termos de visualização de filmes ou de jogos (mínimo 60Hz).

O que é o Ultra HD?

Conforme já foi dito na secção anterior, existem normas para as resoluções dos ecrans. P.ex., uma resolução de 640x480 representa uma imagem com 307.200 pixéis. Mas também podíamos obter este número total de pixéis com imagens de 600x512. O fabrico de ecrans de TV e/ou de monitores obedece a regras de normalização.

O Ultra HD, na realidade, corresponde a dois novos formatos que se irão impor como os mais usados nos próximos anos: O 4K UHD (3840x2160) e o 8K UHD (7680x4320). Existe ainda um formato intermédio, o 5K UHD (5120x2880), usado por alguns fabricantes como a Apple ou a Dell .

Alguns estudos indicam que as novas resoluções de Ultra HD, o 4K e o 8K já terão alcançado o limite máximo de resolução que o olho humano consegue distinguir, principalmente em monitores de menor dimensão.

Mas a grande vantagem destas novas resoluções é que permitem o fabrico de ecrans de maior e maior dimensão, sem perda de qualidade de visualização das imagens exibidas.

Uma listagem das resoluções mais comuns pode ser encontrada aqui.

Então, devo comprar ou não? 

Como é habitual, a resposta a esta questão não é simples.

Uma coisa parece óbvia, neste momento, faz mais sentido comprar um monitor 4K do que uma TV 4K. Porquê? Porque a TV necessita de conteúdos (filmes, séries, shows, jogos) e a quantidade de conteúdos 4K disponíveis ainda é extremamente reduzida. Repare que na actual oferta de TV, a esmagadora maioria dos conteúdos de alta definição (mesmo nos canais HD), costumam ser HD normal (1280x720). Nem sequer são Full HD (1920x1280).

No caso dum monitor de computador, apesar da escassez de conteúdos, podemos sempre beneficiar de uma melhor experiência de utilização do PC, em alta resolução.

Mesmo com uma significativa baixa de preço, as TVs e monitores 4K ainda são bastante dispendiosas (as 8K nem se fala). Então a questão mais concreta será esta: será que o benefício compensa o custo?

Bem, se tiver um dinheiro extra para gastar, então pode investir num equipamento 4K, que, com certeza, vai melhorar a sua experiência de utilização do computador (na TV nem tanto), mas os monitores com resoluções um pouco mais baixas continuam a oferecer excelentes prestações, por um preço consideravelmente mais baixo.

Pode também aguardar mais um tempo. Daqui a uns meses, os preços dos equipamentos 4K serão substancialmente mais baixos e é expectável existirem muito mais conteúdos Ultra HD disponíveis.

Referências 

- "Should You Buy a 4K Computer Monitor?", de Chris Hoffman para a How-To Geek

- "Preços dos monitores 4K começam a descer", na PplWare no Sapo

- "HUMAN EYESIGHT & 4K VIEWING", na Red

Como encontrar a Chave do Windows ou do Office

Se estiver a pensar fazer uma reinstalação do Windows, mas não consegue encontrar a chave do produto, está com sorte, porque esta está armazenada no Registo do Windows ... só que não é fácil de encontrar e é impossível de ler, sem alguma ajuda. Felizmente, estamos aqui para ajudar. Smile

Como se pode ver na imagem abaixo, a identificação do produto é armazenado no registo, mas está em formato binário, que não pode ser lido por seres humanos.

image

Não se compreende porque razão a Microsoft se deu a tanto trabalho para tornar difícil de ver as chaves de produto do seu software, especialmente porque elas são armazenados no registo e pode ser lidas por software. Só podemos supor que eles não querem ninguém a reutilizar uma chave de um computador antigo.

Mas a realidade é que podemos até recuperar uma chave de produto a partir dum computador que já nem sequer arranque o sistema. Tudo o que é necessário é ter acesso ao disco, a partir de outro computador. Mais à frente neste artigo, vamos ver como podemos realizar esta tarefa.

Encontrar a Chave do Windows sem nenhum software

Assumindo que consegue arrancar o computador com o Windows, sem problemas, pode facilmente criar um VBScript simples que vai ler o valor da chave, no registo e, em seguida, vai traduzi-lo para o formato que necessita para a reinstalação.

Temos aqui um exemplo desse VBScript, fornecido por um utilizador do forum da How-To Geek:

Set WshShell = CreateObject("WScript.Shell")
MsgBox ConvertToKey(WshShell.RegRead("HKLM\SOFTWARE\Microsoft\Windows NT\CurrentVersion\DigitalProductId"))
Function ConvertToKey(Key)
Const KeyOffset = 52
i = 28
Chars = "BCDFGHJKMPQRTVWXY2346789"
Do
Cur = 0
x = 14
Do
Cur = Cur * 256
Cur = Key(x + KeyOffset) + Cur
Key(x + KeyOffset) = (Cur \ 24) And 255
Cur = Cur Mod 24
x = x -1
Loop While x >= 0
i = i -1
KeyOutput = Mid(Chars, Cur + 1, 1) & KeyOutput
If (((29 - i) Mod 6) = 0) And (i <> -1) Then
i = i -1
KeyOutput = "-" & KeyOutput
End If
Loop While i >= 0
ConvertToKey = KeyOutput
End Function

Copie o texto acima e cole num novo documento do Bloco de Notas (Notepad). De seguida, escolha a opção Ficheiro | Guardar Como e na opção “Guardar com o tipo”, escolha “Todos os ficheiros (*.*)”. Finalmente, no nome do ficheiro, insira chave_windows.vbs, ou outro nome qualquer, desde que a extensão seja vbs.

Sugerimos coloque no Ambiente de Trabalho, para mais fácil acesso.

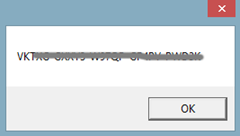
Depois de salvar o ficheiro, basta fazer duplo-clique sobre o mesmo e uma pop-up vai mostrar a chave do Windows do computador:

Use um utilitário para recuperar chaves de produto (mesmo que o Windows do PC não arranque)

A maneira mais fácil de ter acesso a uma chave de produto é através de um utilitário de terceiros.

Vamos usar, como exemplo, o utilitário ProductKey, da NirSoft. As ferramentas desta editora são sempre livres de lixo, e bastante úteis. O único problema com este utilitário em particular é que alguns antivírus irá detectá-lo como um falso positivo, porque alguns malwares podem tentar roubar a sua chave de produto.

Tudo o que necessita é fazer download do ProduKey, descompactá-lo e, em seguida, executá-lo para ver imediatamente todas as suas chaves de produto instaladas. É tão simples como isso.

Pode também fazer o download do ficheiro de tradução para Português. Após descompactar, basta copiar o ficheiro .ini para a pasta onde instalou o utilitário ProductKey.

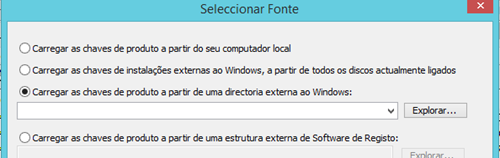
Se quiser recuperar uma chave a partir de um computador que não arranque o sistema, pode ligar o disco rígido a outro PC, e depois executar o ProduKey. Neste caso, usa a opção Ficheiro | Selecionar Fonte e procura a pasta do Windows, no disco do computador avariado. Pode, então, ver as chaves dos produtos.

Também pode usar um Live CD de Linux, para copiar o diretório do Windows do computador avariado, para uma pen-drive, ou copiar apenas os ficheiros de registo, se preferir.

Tradução livre do artigo "How to Find Your Lost Windows or Office Product Keys", de Lowell Heddings para a How-To-Geek.

De volta ao blog II

Boa tarde a todos os meus amigos e seguidores.

Terão notado uma nova ausência na publicação de artigos aqui no Geneesya. Infelizmente os problemas e contratempos da minha vida pessoal agudizaram-se no mês de Dezembro e foi de todo impossível preparar o trabalho para ser publicado. Mais uma vez as minhas desculpas. Volto a retomar o ritmo a partir de agora.

Um grande Muito Obrigado a todos.

Bom Ano Novo!

domingo, 23 de novembro de 2014

Oracle: Índices (1) – Introdução

Introdução

image

De forma análoga ao SQL Server, também no Oracle, a utilização de Índices é essencial para obter alto desempenho numa base de dados (BD).

Num artigo anterior, fizemos uma introdução à utilização de índices no SQL Server. Vamos agora fazer trabalho análogo para os índices do Oracle. Não vamos repetir a explicação detalhada de alguns conceitos base, que já foi efectuada nesse artigo. Em cada tópico, vão ser incluídos links para os tópicos equivalentes no artigo do SQL Server, onde os detalhes podem ser consultados.

Vamos então começar a analisar como podemos usar os índices no Oracle, para obter uma base de dados que tenha uma boa performance, integridade de dados e, ao mesmo tempo, mantenha a sobrecarga associada aos índices, num mínimo.

Conteúdo

O que é um Índice?

Um índice corresponde a uma estrutura em disco, associada a uma  tabela ou view, que agiliza a pesquisa de linhas nessa tabela ou view.

A estrutura do índice é separada da tabela e não afecta a forma como os dados são guardados fisicamente. Afecta sim a forma como são lidos a partir da tabela.

Ver exemplos e detalhe aqui.

Estrutura de um Índice

À semelhança do SQL Server, os índices no Oracle são implementados através de uma estrutura de Árvore-B.

Ver detalhe aqui.

Apesar da estrutura ser idêntica, existe uma diferença essencial, entre o Oracle e o SQL Server, nos dados que são armazenados na estrutura da árvore-B e, consequentemente, na forma como são usados os índices.

Bloco
Um bloco é a menor unidade de disco que o Oracle consegue ler ou escrever. Todos os dados do Oracle - tabelas, índices, clusters - são armazenados em blocos. O tamanho do bloco é configurável para cada BD, normalmente 4Kb, 8Kb, 16Kb ou 32Kb. O tamanho de uma linha de uma tabela é, geralmente, mais pequeno que o tamanho do bloco, por isso o mesmo bloco pode acomodar várias linhas.

A estrutura de árvore-B dos índices do Oracle, guarda o endereço de blocos de BD e não o endereço de linhas de tabela. Então, o Oracle não lê "apenas uma linha", vai ler todo o bloco e ignorar as linhas que não precisa. Minimizar este desperdício é um dos fundamentos da Oracle Performance Tuning.

Tipos de Índices

No Oracle, existem dois tipos principais de índices: B-Tree (nonclustered) e Bitmap.

Existem mais tipos de índices, como cluster, bitmap join, function-based, reverse key e text, mas acabam por ser variantes daqueles dois.

Convém aqui enfatizar que os índices cluster do Oracle não têm nada de semelhante com os índices clustered do SQL Server. No Oracle aquilo que se assemelha às tabelas clustered do SQL Server são as Index-Organized Tables, que também são guardadas numa estrutura árvore-B (em vez de heap), ordenada pela Chave Primária.

Mais informação sobre índices clustered do SQL Server aqui.

Limites dos Índices

No Oracle, também existem algumas limitações internas aos índices.

Tamanho da chave
O tamanho de uma chave de índice está limitado a um máximo de 32 colunas, para índices B-Tree e 30 colunas para índices Bitmap.

Número de índices
Não existe limite para o número de índices numa tabela.

Qualquer destes limites é muito elevado e há poucos casos em que um sistema bem projectado se aproxime sequer deles. Existem duas razões fundamentais para isso não acontecer:

  • À medida que aumenta o número de índices também aumenta o tamanho total ocupado pela tabela (com todos os seus índices). Claro que os discos rígidos são baratos e abundam as soluções de armazenamento, mas o aumento do tamanho duma BD tem outros efeitos: as operações de manutenção (backups, restauros, verificações de consistência e reconstrução de índices) vão levar mais tempo, à medida que o tamanho da BD aumenta;
  • Os índices têm que ser actualizados em sincronismo com as alterações dos dados. Quantos mais índices existirem numa tabela, mais os locais e maior o número de operações necessárias para actualizar. Se existirem 10 índices numa tabela, a inserção duma nova linha tem que ser feita em 11 locais (na tabela e em cada um desses índices).
    Nas BDs que são principalmente de leitura (de suporte à decisão, ou datawarehouses) isto pode ser aceitável. Mas nas BDs em que são frequentes as operações de alteração de dados - inserir, alterar, eliminar (sistemas OLTP), a sobrecarga imposta pela existência de muitos índices pode não ser aceitável.

Como o Oracle usa os Índices

O Oracle pode executar as seguintes operações relacionadas com índices:

INDEX UNIQUE SCAN
Este tipo de pesquisa, usa a estrutura árvore-B para localizar um valor específico. O Oracle usa esta operação se houver um predicado (filtro pesquisável) que garanta que o resultado da pesquisa não tenha mais que uma linha.

INDEX RANGE SCAN
À semelhança da anterior, este tipo de pesquisa, usa a estrutura árvore-B, mas agora para encontrar um conjunto de valores e não apenas um valor específico.

A operação de pesquisa é executada a partir da página de raiz. A partir das linhas desta página, o mecanismo de consultas vai localizar a página do seguinte nível inferior do índice, que contém a primeira linha que está a ser pesquisada. O mecanismo vai, então, ler essa página. Se a página estiver no nível de folha do índice, a pesquisa termina aí. Se não é o nível de folha, então o mecanismo de consulta identifica novamente a página do nível inferior seguinte, que contém o valor especificado. Este processo continua até que o nível de folha seja atingido.

Quando o mecanismo de consultas localiza a página de folha que contém o valor de chave especificado, ou o início do intervalo especificado de valores-chave, vai lendo ao longo das páginas de folha até que todas as linhas correspondentes ao predicado sejam devolvidas. A figura seguinte mostra um exemplo de como uma pesquisa seria feita, num índice, para devolver as linhas com o valor 4 na chave:

INDEX FULL SCAN
Este tipo de pesquisa corresponde a uma leitura completa de todas as páginas de folha do índice. Dependendo de várias estatísticas do sistema, a BD pode executar esta operação se necessitar de todas as linhas, pela ordem do índice – p.ex., por causa de uma cláusula ORDER BY.

Quando a varredura do índice é feita pelo mecanismo de consultas, é sempre uma leitura completa de todas as páginas de folha do índice, independentemente de todas as linhas serem retornadas ou não. Nunca é uma leitura parcial.

Uma varredura não envolve apenas a leitura dos níveis de folha do índice, as páginas de nível superior também são lidas durante a operação.

INDEX FAST FULL SCAN
Este tipo de pesquisa corresponde a uma leitura completa de todas as páginas de folha do índice, conforme guardadas no disco. Esta operação é geralmente realizada em vez de uma varredura (scan) completa da tabela, se todas as colunas necessárias estão disponíveis no índice.

TABLE ACCESS BY INDEX ROWID (Lookup)
Os lookups ocorrem quando o Oracle usa um índice para localizar as linhas pedidas por uma consulta, mas esse índice não contém todas as colunas necessárias para satisfazer a consulta. Para obter as colunas restantes, o Oracle usa o endereço da linha (ROWID), para ler directamente da tabela.

TABLE ACESS FULL ou FULL TABLE SCAN
Lê a tabela inteira - todas as linhas e colunas – conforme armazenada no disco. Apesar da leitura de multi-blocos melhorar consideravelmente a velocidade duma varredura completa de tabela, esta ainda é uma das operações mais pesadas, em termos de BD. Além de altas taxas de I/O, uma varredura completa da tabela tem que inspecionar todas as linhas da tabela, pelo que também pode consumir uma quantidade considerável de tempo de CPU.

Considerações para a criação de Índices

Por mais benéfica que a utilização de índices possa ser, estes devem ser projectados com cuidado. Como resultado, a criação de índices deve levar em conta algumas considerações:

  • Os índices existem, principalmente, para aumentar a performance.
  • Tenha em consideração a relação custo/benefício dos índices.
  • Considere técnicas não-standard e alternativas de indexação, como Índices Bitmap (mas não para OLTP) ou Índices Funcionais.
  • Use ferramentas de análise e tuning, em especial o Execution Plan.
  • Optimize as pesquisas para a utilização de índices. P.ex., um índice não é uma grande ajuda em condições do tipo NOT: <>, NOT IN, NOT LIKE, …

Referências

- "How do indexes work internally in Oracle?", na AskTheOracel.net

- "Understanding Indexes", na Oracle FAQ's

- "Oracle Execution Plan Operations", de Markus Winand para a Use the Index, Luke

- "Managing Indexes", no Oracle Help Center

- "Overview of Indexes", no Oracle Help Center

- "Logical Database Limits", no Oracle Help Center

sexta-feira, 21 de novembro de 2014

Software: Gestão Semântica de Versões (Semantic Versioning)

Introdução

Quem anda no mundo do desenvolvimento de software, sabe que uma das maiores dores de cabeça é a Gestão de Dependências.

Quanto mais um sistema cresce, mais componentes são adicionados, maior é a complexidade e dificuldade de se gerirem as dependências entre os módulos e maior é a probabilidade de se atingirem bloqueios ou inconsistências.

É aqui que entra a Gestão de Versões!

A adopção de um sistema de atribuição de números de versão aos componentes de software, que seja claro e lógico, dá um preciosa ajuda a mitigar os problemas colocados pela gestão de dependências.

Neste artigo, vamos analisar um sistema de gestão de versões, amplamente utilizado, a Gestão Semântica de Versões (Semantic Versioning).

Este sistema é da autoria de Tom Preston-Werner e a sua especificação detalhada pode ser encontrada aqui.

Conteúdo

O que é a Gestão Semântica de Versões (SemVer)?

A Gestão Semântica de Versões, no original Semantic Versioning (referida abreviadamente como SemVer), é um sistema de controlo de versões que tem vindo a ganhar adeptos ao longo dos últimos anos. Com novos plugins, extensões e bibliotecas a ser construídas quase diariamente e com uma forma universal de atribuição de versões a projectos de desenvolvimento de software, é uma ferramenta muito útil para nos ajudar a gerir e manter o registo das evoluções de um sistema.

A especificação SemVer define que o número da versão de um componente de software é composto por 3 partes: Major.Minor.Patch

Cada um destes números é incrementado da seguinte forma:

  • MAJOR (Principal): quando são feitas alterações incompatíveis com a API existente;
  • MINOR (Secundário): quando são adicionadas funcionalidades de forma compatível com versões anteriores;
  • PATCH (Emenda): quando são corrigidos bugs de forma compatível com versões anteriores.

Existem rótulos adicionais para metadados de pré-lançamento (pre-release) e compilação (build), que são disponibilizados como extensões do formato Major.Minor.Patch.

Como funciona a Gestão Semântica de Versões?

Num sistema com muitas dependências, o lançamento de novas versões pode tornar-se um pesadelo muito rapidamente. Isto é conhecido como o “inferno de dependências”. Se as especificações de dependência forem muito apertadas, corre-se o risco de atingir um bloqueio de versão (incapacidade de actualizar um componente, sem ter que actualizar todos os componentes dependentes). Por outro lado, se as dependências forem especificadas de forma muito vaga, então, inevitavelmente, vai-se atingir alguma promiscuidade de versões (é assumida a compatibilidade com mais versões futuras do que seria razoável). Atingiu o inferno de dependências quando um bloqueio de versão e/ou uma promiscuidade de versão o impedem de avançar com o projecto de forma fácil e segura.

A proposta da SemVer é composta por um conjunto simples de regras e requisitos, que determinam a forma como os números de versão são atribuídos e incrementados. Estas regras são baseadas em algumas práticas comuns já existentes. Para que o sistema funcione, é necessário declarar uma API pública, clara e precisa. Esta pode consistir em documentação ou ser forçada pelo próprio código da aplicação. Após a declaração, as alterações à API são comunicadas através de incrementos específicos a cada uma das partes constituintes do número de versão (major, minor ou patch).

O funcionamento da SemVer assenta em saber determinar o momento certo para incrementar o componente correcto, i.e., determinar qual ou quais os números da versão devem ser alterados para cada lançamento do software.

Porquê a Gestão Semântica de Versões?

Porquê usar um sistema de gestão de versões? Porque faz sentido!

Há algo que devemos ter a noção: o controlo de versões sem directrizes, basicamente, não tem significado. Incrementar para a versão 3.2? OK. Mas porquê? Porque não 4? Porque não 3.1.1? Porque não 3.11? Porque não 3.1.nova-versao?

Seguir orientações rigorosas ajuda a dar significado aos números de versão.

Por exemplo, se tivermos a versão 1.3.37, sabemos que este é o primeiro grande lançamento, mas já houve três versões secundárias, com novos recursos. No entanto, também notamos que se trata da emenda 37 a esta versão secundária, o que significa que havia um número razoável de bugs (maiores ou menores) envolvidos.

A SemVer também nos ajuda na gestão de dependências. Vamos imaginar que estamos a construir uma biblioteca chamada Veículos e que nesta biblioteca temos uma dependência sobre o componente Motor. No primeiro lançamento da biblioteca para produção, o componente Motor tem a versão 2.3.8. Isso significa que podemos especificar o Motor como uma dependência da biblioteca Veículos, com versão maior ou igual a 2.3.0, mas menor que 3.0.0. A versão principal significa uma alteração sem compatibilidade com a API actual, pelo que se passarmos o Motor para a versão 3.0.0, nada nos garante que temos compatibilidade com o resto da biblioteca.

Especificação SemVer 2.0.0

A especificações actualizadas para a SemVer pode ser encontradas no endereço: http://semver.org/

À data da criação deste artigo, estamos na versão 2.0.0, com a seguinte especificação:

  1. O software que usa a SemVer TEM QUE declarar uma API pública. Esta API pode ser declarada no próprio código, ou existir explicitamente em documentação. No entanto, quando feita, deve ser precisa e abrangente.
  2. Um número de versão normal deve assumir a forma X.Y.Z, onde X, Y, e Z são inteiros não negativos e não podem conter zeros à esquerda. X é a versão principal (Major), Y é a versão secundária (Minor) e Z é a versão da emenda (Patch). Cada elemento deve aumentar numericamente. Por exemplo: 1.9.0 –> 1.10.0 -> 1.11.0.
  3. Sempre que um pacote seja lançado, o seu conteúdo NÃO PODE ser modificado. Qualquer modificação deve ser lançada como uma nova versão.
  4. A versão principal (Major) a zero (0,y,z) serve para o desenvolvimento inicial. Qualquer coisa pode mudar a qualquer altura. A API pública não deve ser considerada estável.
  5. A versão 1.0.0 define a API pública. A forma como o número de versão é incrementado a partir deste lançamento inicial, depende dessa API pública e de como ela é alterada.
  6. A versão de emenda (Patch) Z (x.y.z | x>0) SÓ PODE ser incrementada se for introduzida uma correcção de um bug compatível com a API pública. A correcção de um bug define-se como uma alteração interna que corrige um comportamento incorrecto.
  7. A versão secundária (Minor) Y (x.y.z | x>0) SÓ PODE ser incrementada se for introduzida uma nova funcionalidade compatível com a API pública. A versão secundária TEM QUE ser incrementada sempre que uma funcionalidade da API pública for marcada como obsoleta. A versão secundária PODE ser incrementada pela introdução de novas funcionalidades ou melhorias substanciais, no código privado. PODE ainda incluir alterações ao nível da emenda (Patch). A versão de emenda (Patch) TEM QUE ser reposta a zero quando a versão secundária (Minor) é incrementada (1.3.55 –> 1.4.0).
  8. A versão principal (Major) X (x.y.z | x>0) TEM QUE ser incrementada se for introduzida uma alteração incompatível com a API pública. PODE incluir alterações ao nível secundário (Minor) e emendas (Patch). Tanto a versão secundária (Minor), como a versão de emenda (Patch) TÊM QUE ser repostas a zero quando a versão principal (Major) é incrementada (1.3.55 –> 2.0.0).
  9. Uma versão de pré-lançamento (pre-release) PODE ser identificada acrescentando um hífen e uma série de identificadores, separados por pontos, imediatamente após a versão de emenda (Patch). Os identificadores terão as seguintes características:
    • SÓ PODEM incluir caracteres alfanuméricos ASCII e hífen [0-9A-Za-z];
    • Um identificador NÃO PODE estar vazio;
    • Um identificador numérico NÃO PODE conter zeros à esquerda.
    As versões de pré-lançamento têm uma precedência mais baixa que a versão normal associada. Uma versão de pré-lançamento indica que a versão é instável e pode não satisfazer todos os requisitos de compatibilidade pretendidos, conforme indicado na sua versão normal associada. Exemplos: 1.0.0-alpha, 1.0.0-alpha.1, 1.0.0-beta, 1.0.0-RC, 1.0.0-0.3.7, 1.0.0-x.7.z.92.
  10. Podem ser identificados metadados de compilação (build) acrescentando um sinal de mais e uma série de identificadores, separados por pontos, imediatamente após a versão de emenda (Patch) ou pré-lançamento. Os identificadores terão as seguintes características:
    • SÓ PODEM incluir caracteres alfanuméricos ASCII e hífen [0-9A-Za-z];
    • Um identificador NÃO PODE estar vazio.
    Os metadados de compilação (build) DEVEM ser ignorados na determinação da precedência de versões. Assim  duas versões que diferem apenas nos metadados de compilação têm a mesma precedência. Exemplos: 1.0.0-alpha+001, 1.0.0+20130313144700, 1.0.0-beta+exp.sha.5114f85.
  11. A Precedência refere-se ao modo como as versões são comparados umas com as outras, quando ordenadas. A precedência TEM QUE ser calculada através da separação da versão em principal (Major), secundária (Minor), emenda (Patch) e de pré-lançamento, nessa ordem (metadados de compilação (build) não figuram na precedência).
    A precedência é determinada pela primeira diferença quando se compara cada um destes identificadores, da esquerda para a direita, como se segue: as versões principal, secundária e emenda são sempre comparados numericamente. Exemplo: 1.0.0 < 2.0.0 < 2.1.0 < 2.1.1. Quando as versões principal, secundária e emenda são iguais, a versão de pré-lançamento tem precedência menor do que a versão normal. Exemplo: 1.0.0-alpha < 1.0.0.
    A precedência de duas versões de pré-lançamento com as versões principal, secundária e emenda iguais, TEM QUE ser determinada comparando cada identificador separado por pontos, da esquerda para a direita, até que seja encontrada uma diferença, da seguinte forma: identificadores que consistem apenas em dígitos, são comparados numericamente e identificadores com letras ou hífens são comparados lexicalmente por ordem do código ASCII. Os identificadores numéricos têm sempre menor precedência que os identificadores alfanuméricos.
    Um conjunto maior de identificadores de pré-lançamento tem uma precedência maior do que um conjunto menor, se todos os identificadores anteriores forem iguais. Exemplo: 1.0.0-alfa < 1.0.0-alpha.1 < 1.0.0-alpha.beta < 1.0.0-beta < 1.0.0-beta.2 < 1.0.0-beta.11 < 1.0.0-rc.1 < 1.0.0.

FAQ

Como devo lidar com revisões na fase de desenvolvimento inicial (0.y.z)?

A coisa mais simples a fazer é começar a versão de desenvolvimento inicial em 0.1.0 e incrementar a versão secundária a cada lançamento subsequente.

Como sei quando lançar a versão 1.0.0?

Se o software já está a ser usado em produção, então já deve estar na versão 1.0.0. Se possui uma API estável, da qual os utilizadores passaram a depender, então deve ser a 1.0.0. Se já se está a preocupar bastante com compatibilidade com versões anteriores, então já deve ser a 1.0.0.

Isto não desencoraja o desenvolvimento ágil (Agile) e iteração rápida?

A versão principal (Major) a zero tem o foco exatamente no desenvolvimento rápido. Se estiver a mudar a API todos os dias, provavelmente está na versão 0.y.z ou num branch separado de desenvolvimento, a trabalhar numa próxima versão principal.

Se mesmo a menor mudança incompatível com a API pública requer aumento da versão principal (Major), não vou acabar na versão 42.0.0 muito rapidamente?

Esta é uma questão de desenvolvimento responsável e conhecimento antecipado. Mudanças incompatíveis não devem ser introduzidas de forma ligeira em software que tem muito código dependente. O custo necessário à atualização pode ser significativo. Ter que aumentar a versão principal para introduzir mudanças incompatíveis, significa que pensará no impacto dessas mudanças e que avaliará a relação custo/benefício envolvida.

Documentar toda a API pública dá muito trabalho!

É sua responsabilidade como programador profissional documentar corretamente o software que vai ser usado por outros. Gerir a complexidade do software é uma parte extremamente importante de manter um projeto eficiente e isso é difícil de fazer se ninguém sabe como usar o seu software, ou que métodos são seguros de chamar. A longo prazo, a SemVer e a insistência numa API pública bem definida, podem manter tudo e todos a funcionar suavemente.

O que eu faço se, acidentalmente, lançar uma mudança incompatível com versões anteriores como uma versão secundária (Minor)?

Assim que perceber que não cumpriu a especificação da SemVer, repare o problema e lance uma nova versão secundária, que corrige o problema e restaura a compatibilidade. Mesmo nesta circunstância, é inaceitável modificar versões já lançadas. Se for apropriado, documente a versão incumpridora e informe os seus utilizadores do problema, de forma a que eles fiquem cientes da versão em questão.

O que devo fazer se atualizar as minhas próprias dependências sem modificar a API pública?

Isso seria considerado compatível, uma vez que não afeta a API pública. Software que depende explicitamente das mesmas dependências que o seu pacote, deve ter a sua própria especificação de dependência e o autor notificará quaisquer conflitos. Para determinar se a mudança é ao nível de emenda (Patch) ou ao nível secundário, dependente se atualizou as dependências a fim de corrigir um bug ou introduzir uma nova funcionalidade.

E se alterei inadvertidamente a API pública de forma incompatível com a mudança no número de versão (ex.: o código introduz, incorretamente, uma grande mudança incompatível, no lançamento de um patch)

Use o bom senso. Se tiver uma audiência enorme, que será drasticamente afectada pela mudança de comportamento de voltar ao que a API pública pretendia, então pode ser melhor realizar um lançamento de uma versão principal (Major), mesmo que a correção pudesse ser considerada estritamente uma versão de emenda (Patch). Lembre-se, SemVer trata de transmitir significado à forma como os números de versão mudam. Se estas mudanças são importantes para os seus utilizadores, utilize o número da versão para informá-los.

Como devo lidar com descontinuação de funcionalidades?

Descontinuar funcionalidades (deprecating) é um processo comum no desenvolvimento de software e muitas vezes é necessário para poder haver progresso. Quando descontinua partes da sua API pública, deve fazer duas coisas: (1) atualizar a sua documentação, para que os utilizadores saibam das mudanças, (2) lançar uma versão secundária (Minor) que anuncie a descontinuação. Antes de remover completamente a funcionalidade numa versão principal (Major), deve haver, pelo menos, uma versão secundária (Minor) que possui a descontinuação anunciada, permitindo com que os utilizadores façam uma transição tranquila para a nova API.

A SemVer tem um limite de tamanho para o número de versão?

Não, mas use o bom senso. Uma string de versão com 255 caracteres, por exemplo, é provavelmente um exagero. Porém, sistemas específicos podem definir seus próprios limites para o tamanho da string.

Licença

A Especificação da SemVer é da autoria de Tom Preston-Werner, criador do Gravatar e co-fundador do GitHub.

A SemVer é disponibilizada sob a licença Creative Commons - CC BY 3.0.

Caso queira deixar feedback, por favor abra um issue no GitHub.

Referências

Semantic Versioning 2.0.0

"Semantic Versioning: Why You Should Be Using it", de Hugo Giraudel para o SitePoint.

sexta-feira, 14 de novembro de 2014

Windows: Qual a diferença entre edição “OEM” e “Retalho”

Já tentou comprar uma licença do Windows na Amazon ou outra loja online? E em lojas nacionais, como a FNAC ou a WORTEN?

Parece simples, mas nem sempre é. A realidade é que vai encontrar licenças System Builder (OEM), mais baratas e licenças Full Version (Retalho), mais caras.

Então a pergunta que se coloca é: Qual a diferença entre estas versões?

Antes de mais, devemos esclarecer que, no que toca a funcionalidades, ambas as edições são idênticas, i.e., instalando uma versão OEM ou uma versão de Retalho, o seu Windows funciona da mesma forma.

Vamos ver um pouco mais em detalhe as diferenças.

As licenças destinam-se a alvos diferentes

Os dois tipos de licença diferem conceptualmente. A licença OEM é destinada aos fabricantes e integradores de hardware, que constroem computadores para depois vender a terceiros, enquanto a licença de Retalho se destina ao público em geral (pelo menos em teoria – a realidade é que a maioria dos utilizadores não compra o Windows numa caixa).

Licenças Versão Completa/Retalho (Full Version/Retail)
Estas são as licenças standard para o consumidor do Windows. Elas foram projectadas para os normais utilizadores de computadores, que pretendem comprar uma licença para actualizar a sua máquina para uma nova versão do Windows. Este tipo de licença permite ao utilizador instalar o Windows em qualquer computador e mesmo mudar para outro, mas a mesma licença só pode estar instalada num único PC em cada momento.

Se alguma vez entrou numa loja de informática e viu uma caixa com o logo do Windows, numa prateleira, então estava a olhar para uma edição de Retalho do Windows.

Licenças Integrador Sistemas/OEM (System Builder/OEM)
Estas licenças são usadas pelos fabricantes de computadores (OEM – Original Equipment Manufacturers). São usadas não só pelos grandes fabricantes como IBM, Asus ou Dell, como pelos pequenos integradores e lojas locais de informática, onde podemos comprar computadores com configurações à medida. Este tipo de licença fica vinculada ao PC onde é instalada a primeira vez, para sempre. Não pode ser usada noutro PC.

Posso usar uma licença OEM?

A Microsoft tem alternado a sua política no tocante a permitir ou não que os normais entusiastas da computação usem licenças OEM, quando constroem as suas próprias máquinas.

No Windows XP, Windows Vista, e Windows 8, era permitido.
No
Windows 7 e agora no Windows 8.1, não é permitido.

Mas não vai saber isto a não ser que leia as letras miúdas das licenças.

Antes do Windows 7, a compra de uma licença OEM para o seu próprio PC era perfeitamente legítima. Com o Windows 7, a Microsoft alterou as populares licenças OEM do Windows. As pessoas normais deixaram de estar autorizadas a usá-las para construir seus próprios PCs, mas a Microsoft continuou a vender massivamente as licenças OEM a essas mesmas pessoas. Por exemplo, este ainda é o S.O. mais vendido na Amazon e a Microsoft sabe porquê: porque as pessoas normais compram a versão OEM (mais barata).


A Microsoft viu que a desregulação do licenciamento OEM do Windows 7 estava de loucos, por isso resolveu corrigir a situação no Windows 8 - foi acrescentada uma permissão de “Licença de Uso Pessoal”, à licença OEM do Windows 8. Isso significa que pode comprar uma licença Windows 8 OEM e usá-la num computador que esteja a montar em casa, para seu uso pessoal.

No fim de contas, as pessoas estavam a usar licenças OEM nas suas máquinas pessoais e a Microsoft acabou simplesmente por normalizar a situação que ela própria tinha criado com a alteração ao licenciamento do Windows 7.

Entretanto, chegou o Windows 8.1, que é considerado pela Microsoft como um S.O. completamente novo. E tem novas regras de licenciamento também. A permissão de uso pessoal foi retirada da licença OEM, voltando à situação do Windows 7, sendo apenas permitida para integradores que montem máquinas para revenda.

Esta questão está claramente resumida no guia de licenciamento para uso pessoal, para parceiros OEM, da Microsoft (pode ser consultado aqui):

No entanto, já passou mais de um ano e continuamos a encontrar as cópias OEM do Windows 8.1 no topo de vendas da Amazon ou da Newegg. As pessoas continuam a comprar estas licenças, que representam uma poupança significativa, relativamente às versões de Retalho. Claramente, são compradas para uso pessoal e não por integradores ou fabricantes de computadores.

A informação sobre o licenciamento nestes sites não dizem claramente “ESTA LICENÇA NÃO É AUTORIZADA PARA USO NO SEU PRÓPRIO PC”, que é o deveria dizer se a Microsoft pensasse em levar a sério os termos do seu contrato de licença OEM. Quando pesquisa o Windows 8.1 no site da Amazon, é exibida uma mensagem que diz mais ou menos isto: “Se for um integrador de sistemas, a Amazon oferece-lhe produtos Windows OEM. Caso contrário compre os nossos títulos Windows 8.1”. Esta mensagem é demasiado vaga – qualquer pessoa que esteja a montar o seu próprio PC, pode pensar que é um integrador de sistemas. Mas não é - pelo menos de acordo com os termos da licença do Windows 8.1. Todavia, com o Windows 8, já era um integrador de sistemas. No Windows 7 também não era, mas nos anteriores era. Confuso o suficiente? Bem, as pessoas podem estar confundidas, mas as licenças OEM continuam a vender bem. Winking smile

Limitações das licenças OEM

Apesar de mais baratas, as licenças OEM têm algumas limitações (legítimas):

  • Licença só pode ser usada num único PC
    Após instalar a sua cópia OEM do Windows, a licença fica vinculada ao computador, para sempre. Especificamente, fica vinculada ao modelo de motherboard. A licença OEM fica associada a um único sistema, enquanto com uma licença de Retalho pode usá-la noutro computador, no futuro.
  • Sem suporte directo da Microsoft
    Não dão direito a suporte directo e gratuito por parte da Microsoft. A licença OEM estipula que o construtor do sistema é o responsável por fornecer o suporte – quando compra um computador com versão OEM do Windows, é suposto a empresa ou pessoa que que lho vendeu providenciar o suporte. Se montar o seu próprio computador com uma licença OEM do Windows, então é responsável por fornecer o seu próprio suporte. Claro que as licenças Windows OEM permitem obter e instalar as actualizações do Windows Update.
  • Escolher 32 bits ou 64 bits na compra
    Quando compra uma versão OEM do Windows, tem que escolher a media de instalação de 32 bits ou de 64 bits, enquanto na versão de Retalho, a mesma media permite instalar a edição de 32 bits ou a de 64 bits. Como a licença OEM é para usar num único PC, espera-se que a escolha da versão 32 bits ou 64 bits seja feita no momento da compra (claro que hoje em dia, deve querer apenas a edição de 64 bits, de qualquer forma).
  • Não pode ser usada para atualizar o sistema
    A cópia OEM do Windows não pode ser usada para actualizar uma versão mais antiga do Windows – p.ex., a atualização do Windows XP para o Windows 7, ou do Windows 7 para o Windows 8.1. A licença está projectada para instalação em PCs novos, que ainda não tenham qualquer sistema operativo.

Que licença devo comprar?

Supondo que não tem problemas em ultrapassar os constrangimentos do licenciamento, uma versão OEM do Windows faz muito sentido se você for um geek, a construir o seu próprio PC. Se estiver disposto a vincular essa cópia do Windows ao seu hardware e não precisar ligar para o suporte da Microsoft, pode economizar algum dinheiro.

Quanto dinheiro vai poupar, depende da edição do Windows que quiser comprar e da loja onde comprar, mas, numa loja como a Amazon, consegue economizar entre os 15% e os 40%.

A Microsoft já não comercializa versões de Retalho do Windows 7, embora continue a vender versões OEM. Isto leva a situações de termos as poucas licenças de Retalho, ainda disponíveis, a custar 4 ou 5 vezes o valor da versão OEM.

Referências

“What’s the Difference Between the “System Builder” and “Full Version” Editions of Windows?”, de Chris Hoffman para a How-To-Geek.

"Microsoft is Misleading Consumers With Windows 8.1 System Builder Licensing", de Chris Hoffman para a How-To-Geek.